
Индексация сайта - это процесс, при котором поисковый робот находит страницы, загружает их и сохраняет в базу поисковой системы - индекс. Страницу, которой нет в индексе, невозможно найти в Яндексе или Google. Проверяют индексацию в Яндекс Вебмастере и Google Search Console, а ускоряют файлом Sitemap и переобходом. В Яндексе после обхода страницы могут появиться в поиске в течение двух недель; сроков и гарантий Яндекс не обещает.
Материал помогает владельцу бизнеса и маркетологу понять, почему новый сайт не виден в поиске, и самостоятельно проверить индексацию за десять минут. А ещё - отличить ситуацию, когда подрядчик прав со своим «ждём индексации», от ситуации, когда пора искать причину. Сроки и названия разделов сверены по официальным справкам на октябрь 2026 года.
Коротко:
- Индексация - не разовое событие, а постоянный цикл: робот обходит сайт, обновляет копии страниц и решает, какие из них будут участвовать в поиске. Попасть в индекс - условие показа, но не гарантия позиций.
- В Яндексе после обхода страницы могут появиться в поиске в течение двух недель, в Google сканирование занимает от нескольких дней до нескольких недель. Сроки в справках - ориентиры, а не гарантии. «Индексация за минуты» бывает, но это частный случай, а не норма.
- Одну страницу проверяют за минуту оператором
url:в Яндексе иsite:в Google. Точный ответ дают «Проверка страницы» в Вебмастере и инструмент проверки URL в Search Console. - Ускоряют индексацию Sitemap, переобход, обход по счётчику Метрики и IndexNow; последние два - инструменты Яндекса, а для Google работают Sitemap и проверка URL. Для Google справка прямо говорит, что увеличение числа запросов на индексирование не ускоряет процесс.
- Исключённые страницы - не всегда ошибка: дубли, редиректы и служебные адреса не должны быть в поиске. Чинить нужно ошибки сервера, случайные запреты и выпавшие важные страницы.
Нужно другое значение слова? Индексация в Windows, во ВКонтакте и в экономике разобрана в разделе «Индексация в других значениях» ближе к концу статьи.
Что такое индексация сайта простыми словами
Индексация - это внесение страниц сайта в «каталог» поисковой системы. Робот находит страницу, читает её содержимое и сохраняет в поисковую базу - индекс. Когда человек вводит запрос, поисковик ищет ответ не по всему интернету, а по этой базе. Страница, которой в индексе нет, в выдаче быть не может. Что значит индексация для владельца сайта: страницы в базе - есть шанс на показ, страниц нет - нет и показов.
Так же определяет процесс и сам Яндекс. В справке «Как работает поиск Яндекса» сохранение страниц в базу и их дальнейшая обработка алгоритмами названы индексированием, и уже на его основе формируются результаты поиска.
Пример с библиотечным каталогом
Интернет похож на огромную библиотеку без описи. Поисковый индекс - это каталог карточек, а робот - библиотекарь, который ходит по полкам (по ссылкам) и заводит карточку на каждую новую книгу. Читатель ищет по каталогу, а не по полкам. Книги без карточки для него не существует.
У этого образа есть важная поправка. Библиотечный каталог составляют один раз, а поисковый индекс переписывается постоянно. По справке Яндекса, роботы непрерывно отслеживают появление новых ссылок, обновление содержимого загруженных страниц и их доступность. Робот возвращается, обновляет «карточки» и убирает те, что ведут на исчезнувшие страницы.
На практике: индексация - процесс, а не галочка. Страница, которая была в поиске вчера, может выпасть завтра, если сервер начал отдавать ошибку или на неё случайно поставили запрет.
Индексация и индексирование: есть ли разница
Разницы нет. Индексирование - термин документации: так пишут справки Яндекс Вебмастера. Индексация - разговорный вариант, который чаще звучит в речи и встречается в поисковых запросах. По смыслу справки эти слова не разделяют.
Что такое веб-индексация: это то же самое, что индексация сайта. Слово подчёркивает, что речь о страницах в интернете, а не о файлах на компьютере (о другом значении - в разделе «Индексация в других значениях»). SEO-индексация - тоже не отдельный вид, а та же индексация, о которой говорят в контексте продвижения. В справках Яндекса и Google, которые открывались при подготовке материала, деления на «первичный» и «дополнительный» индекс нет.
Что значит «проиндексировать» и «страница индексируется»
Глагольные формы ищут отдельно, и у каждой свой оттенок:
- Что значит индексировать: вносить страницы в поисковую базу. Это делает поисковая система, а не владелец сайта: владелец только помогает роботу найти страницу и не мешает её загрузить.
- Что значит проиндексировать (проиндексировался): страница уже внесена в базу и может показываться в поиске.
- Индексируется - что это значит: у слова два смысла. Первый - «страница доступна для индексации», то есть не закрыта запретами. Второй - «робот сейчас обходит страницу».
- Индексируемость - способность сайта быть проиндексированным: доступен ли он роботу, нет ли запретов и ошибок сервера.
Оговорка: «проиндексирована» и «показывается по запросу» - не одно и то же. Справка Яндекса о важных страницах прямо предупреждает: страница может обходиться роботом, но при этом отсутствовать в поиске.
Что такое индекс сайта и поисковый индекс
Поисковый индекс - база данных поисковой системы, в которой хранятся сведения о страницах. В руководстве по принципам работы Google Поиска индекс описан как большая база данных, размещённая на тысячах компьютеров. Интернет-индекс - другое название того же понятия.
Индекс сайта в речи владельцев - это страницы конкретного сайта, которые есть в этой базе. В Яндекс Вебмастере их число видно в столбце «В поиске» списка сайтов аккаунта и в разделе «Страницы в поиске».
Индекс сайта не стоит путать с ИКС - индексом качества сайта Яндекса. ИКС оценивает сайт целиком, а индексация отвечает только за попадание страниц в базу.
Индексатор - программа-робот, которая обходит и загружает страницы. У Яндекса основной индексирующий робот - YandexBot, у Google - Googlebot.
Зачем бизнесу индексация
Для чего нужна индексация? Она - первое звено цепочки: без индексации нет показов, без показов нет кликов, без кликов нет заявок из поиска. Поэтому её называют первым условием SEO: без неё не работают ни тексты, ни ссылки, ни остальная оптимизация.
Но есть и обратное правило: в индексе должны быть только нужные страницы. По справке Яндекса о дублях, когда на сайте есть дубли, робот индексирует вместо одной страницы несколько и тратит на их обход время. Новые страницы из-за этого могут индексироваться дольше, а целевую страницу робот может исключить, посчитав дублем другую.
Итого: задача владельца - не «загнать в индекс всё», а добиться, чтобы в индексе были все важные страницы и не было лишних.
Короткий словарь индексации:
- Индекс - база данных поисковой системы со сведениями о страницах, по которой строится выдача.
- Индексирование (индексация) - сохранение страниц в поисковую базу и их обработка алгоритмами.
- Поисковый робот (краулер) - программа, которая находит и загружает страницы сайтов.
- Обход (сканирование) - посещение страницы роботом и загрузка её содержимого.
- Проиндексирована - страница внесена в поисковую базу и может участвовать в поиске.
- Исключена из поиска - робот знает о странице, но алгоритм не включил её в выдачу.
С терминами разобрались. Дальше - как устроен путь страницы в поиск и на каком шаге она может потеряться.
Как поисковые системы индексируют сайт: 4 этапа
По справке Яндекса, путь страницы в поиск состоит из четырёх этапов. Это обход сайта роботом, загрузка и обработка данных, формирование базы страниц для поиска и формирование результатов поиска. У Google этапов три - сканирование, индексирование и показ результатов, - но логика та же. На каждом этапе страница может выбыть, и у каждого этапа своя проверка.
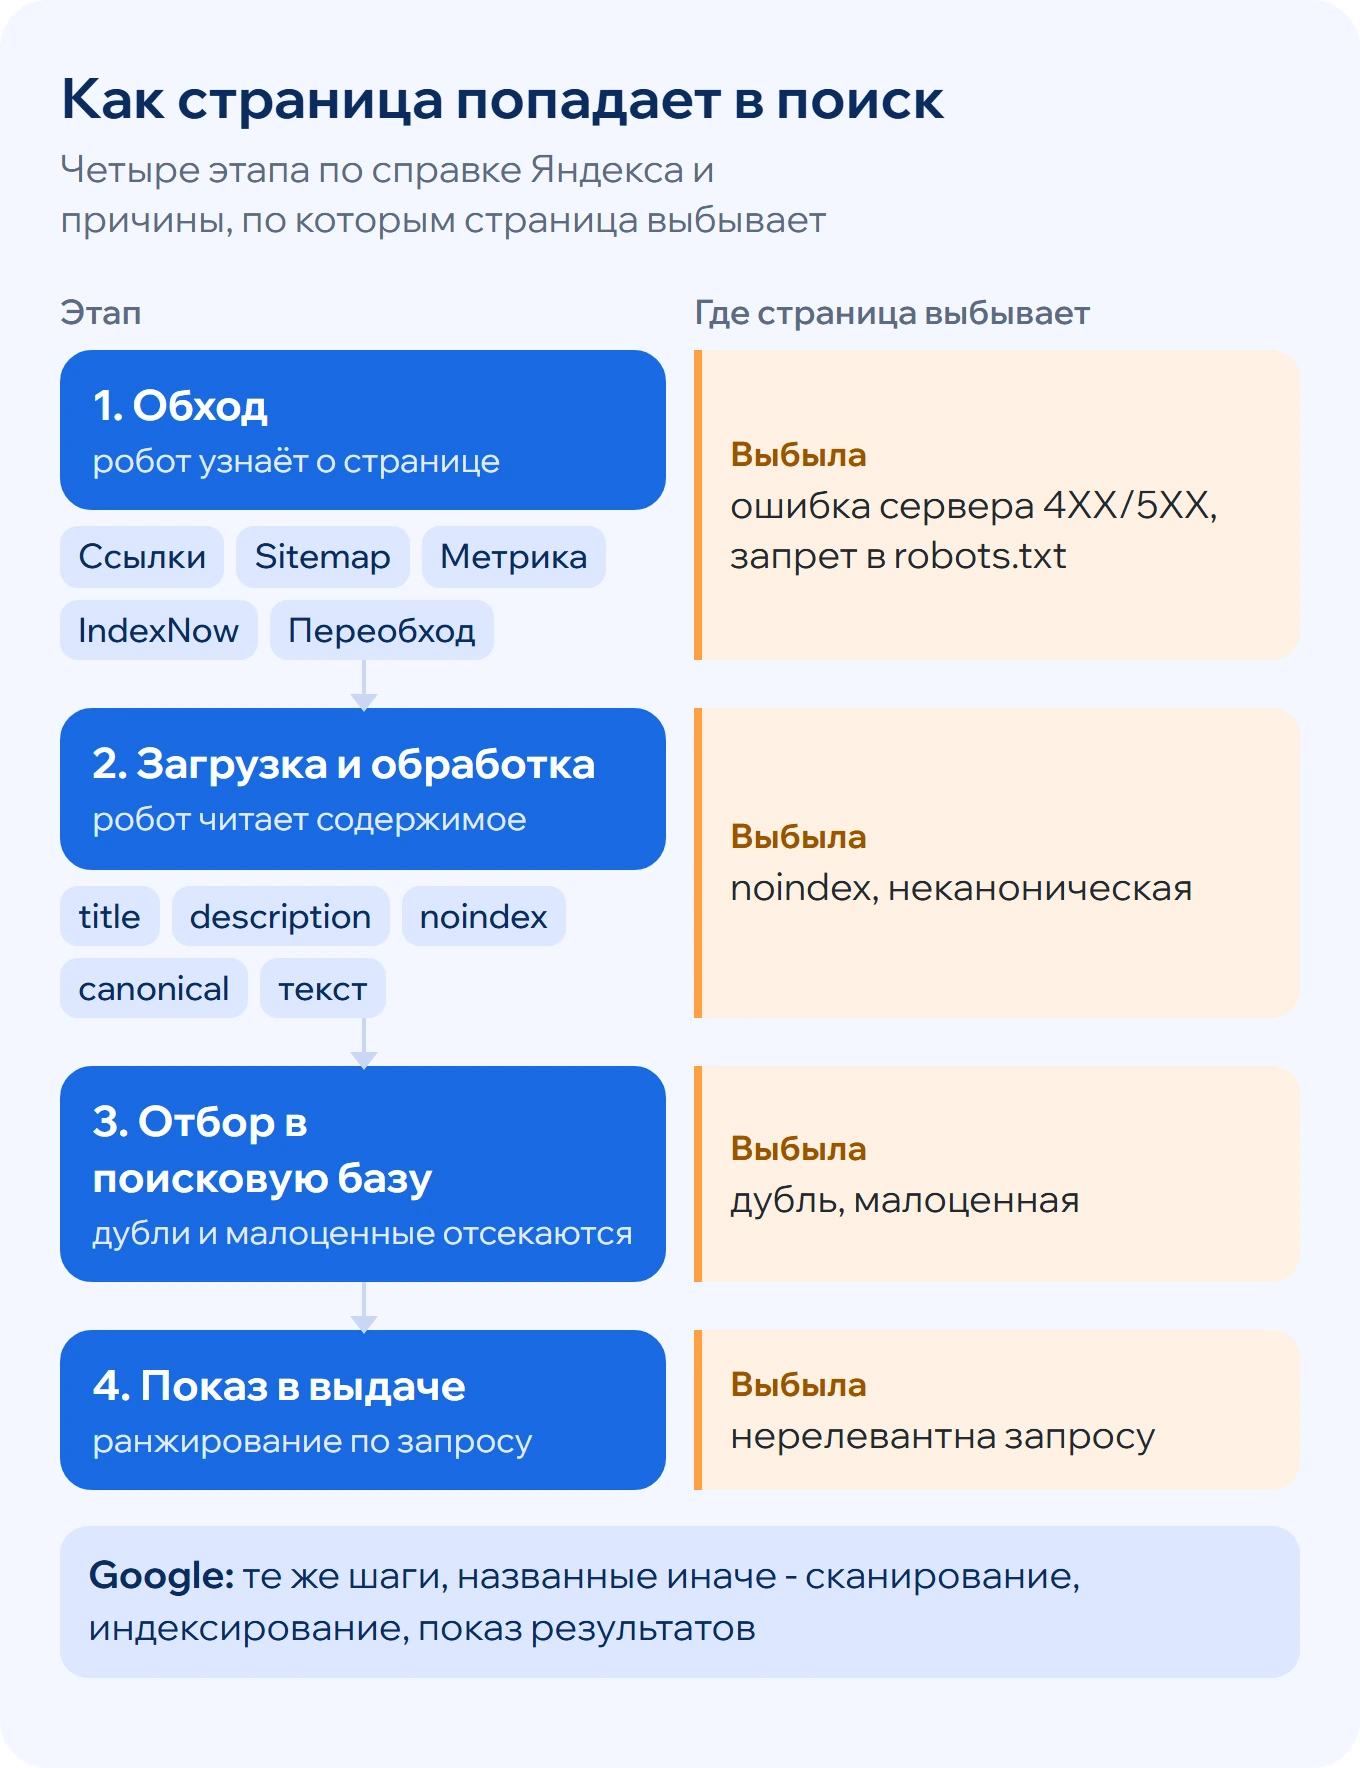
Коротко по схеме:
- Обход - робот узнаёт о странице и загружает её.
- Загрузка и обработка - робот читает содержимое и служебные указания.
- Отбор в поисковую базу - алгоритм решает, может ли страница участвовать в поиске.
- Показ в выдаче - страница ранжируется по конкретному запросу.
Этап 1. Робот узнаёт о странице и обходит её
Список известных страниц робот Яндекса строит из нескольких источников: внутренних и внешних ссылок, файла Sitemap, данных Яндекс Метрики и директив robots.txt. Это перечислено в справке «Как работает поиск Яндекса». Там же указан лимит: страницы больше 10 МБ не индексируются.
Какие сайты, как часто и сколько страниц обходить, робот решает сам; Google в своей документации пишет о том же. Владелец сайта может только подать сигнал и убрать помехи.
От ответа сервера зависит, что робот сделает дальше:
- 200 OK - страница доступна, робот её обходит.
- 3XX (редирект) - робот переходит на страницу, куда ведёт перенаправление.
- 4XX и 5XX - страница не будет участвовать в поиске, а если уже была в нём, будет удалена.
- 429 - робот повторит попытку позже, не удаляя страницу из поиска.
Код 429 выручает при временной поломке сайта: страница не выпадет из поиска сразу. Но если страница долго отвечает кодом 429, справка трактует это как признак того, что серверу тяжело с нагрузкой. Держать такой ответ неделями не стоит.
Отдельный случай - сайты, где содержимое появляется только после выполнения скриптов. Google, по документации о работе Поиска, отрисовывает страницы и выполняет JavaScript в актуальной версии Chrome. У Яндекса для таких страниц в Вебмастере есть раздел «Индексирование → Рендеринг страниц JavaScript» (справка «Проверка страницы»).
Этап 2. Загрузка и обработка: что робот читает на странице
На этом этапе робот разбирает страницу по частям. По справке Яндекса, он анализирует:
- title и description - заголовок и описание страницы для выдачи;
- микроразметку Schema.org - данные для расширенного сниппета;
- метатег robots с noindex - если он найден, страница не попадёт в поиск;
- атрибут rel=canonical - указание, какую из похожих страниц считать основной;
- текст, изображения и видео - само содержимое.
Если содержимое нескольких страниц совпадает, робот может признать их дублями. Google на этом шаге выбирает каноническую страницу из группы похожих. Указание canonical - распространённый инструмент: по данным HTTP Archive Web Almanac 2025, оно есть на 68% десктопных и 67% мобильных страниц из выборки исследования. Данные мировые, отдельно по России и Яндексу они не считались.
Этап 3. Отбор в поисковую базу: почему не всё обойдённое попадает в поиск
Обход ещё не гарантирует места в базе. Алгоритмы Яндекса отбирают страницы, которые могут участвовать в поиске, а закрытые от индексации и дубли исключают. По справке, алгоритм может не добавить даже оригинальную страницу, если вероятность её попадания в зону видимости низкая - из-за невостребованности или высокой конкуренции в теме.
В Вебмастере такие страницы получают статус «малоценная или маловостребованная». Google пишет о том же: он не гарантирует, что все обработанные страницы будут проиндексированы. Разбор этого статуса - в разделе «Почему сайт или страница не индексируется».
Этап 4. Показ в выдаче: индекс не равен позициям
Попасть в базу - условие, а место в выдаче определяет ранжирование. Яндекс при формировании результатов оценивает релевантность, полезность и удобство страницы. Страница может быть в индексе и при этом не показываться по нужному запросу: она проигрывает конкурентам или отвечает на другой вопрос.
Механика у Яндекса и Google общая. Различаются инструменты и отдельные правила - о них следующий раздел.
Индексация в Яндексе и Google: в чём разница
Принцип одинаковый, различаются инструменты и правила. Яндекс принимает сигналы о новых страницах через Вебмастер, счётчик Метрики и протокол IndexNow, понимает HTML-элемент <noindex> и директиву Clean-param. Google работает через Search Console, Sitemap и проверку URL. Поэтому сайт добавляют в обе панели и проверяют индексацию в каждой отдельно.
Что общего у Яндекса и Google
- Оба поисковика сами решают, какие страницы и когда обходить.
- Оба принимают файл Sitemap.
- Оба понимают метатег robots с noindex и атрибут rel=canonical.
- Платной индексации в справках нет. Google в руководстве о работе Поиска прямо пишет, что не взимает плату за более частое сканирование сайтов или повышение позиций. В изученных справках Яндекса платных способов ускорить индексирование не названо.
Последний пункт стоит запомнить. Если подрядчик предлагает «платную ускоренную индексацию», он продаёт то, за что Google плату прямо не берёт, а в изученных справках Яндекса такой услуги нет вовсе. Поисковик индексирует страницы по своему расписанию.
Чем отличается индексация в Яндексе
Индексация сайта в Яндексе опирается на инструменты, которых у Google нет:
- обход по счётчикам Метрики - Вебмастер получает адреса популярных страниц из привязанного счётчика;
- протокол IndexNow - автоматическое уведомление о новых, изменённых и удалённых страницах;
- HTML-элемент
<noindex>- запрет индексации части текста на странице (справка «Как запретить индексирование»); - директива Clean-param в robots.txt - для GET-параметров, которые не нужно учитывать при индексировании;
- запрет для Алисы AI - роботам YandexAdditional и YandexAdditionalBot можно запретить использовать страницы в ответах Алисы AI; подробности - в разделе «Как закрыть страницы от индексации и что такое деиндексация».
Чем отличается индексация страниц в Google
Индексация страниц в Google управляется через Search Console. Для отдельного адреса есть инструмент проверки URL с кнопкой «Запросить индексирование», для множества адресов - файл Sitemap.
Две особенности Google, которые часто упускают:
- noindex в robots.txt не работает. Документация «Блокировка индексирования при помощи директивы noindex» прямо говорит, что такое правило в robots.txt не поддерживается. Запрет ставят метатегом или HTTP-заголовком X-Robots-Tag.
- Индексирование по мобильной версии. По документации Google, при индексировании и ранжировании используется мобильная версия сайта, просканированная Googlebot для смартфонов. Отдельная мобильная версия не обязательна, но содержимое, метаданные и структурированные данные мобильной и полной версий должны совпадать.
HTML-элемента <noindex> в документации Google нет: там перечислены только директивы метатега robots. IndexNow Google тоже не поддерживает - на официальном сайте протокола на 06.10.2026 названы Microsoft Bing, Naver, Seznam.cz, Yandex и Yep.
| Параметр | Яндекс | |
|---|---|---|
| Панель для владельца сайта | Яндекс Вебмастер | Google Search Console |
| Основной робот | YandexBot | Googlebot |
| Как сообщить о новой странице | «Переобход страниц», Sitemap, обход по счётчикам Метрики, IndexNow | Инструмент проверки URL («Запросить индексирование»), Sitemap |
| IndexNow | Поддерживается | Нет в списке поддерживающих систем |
| Запрет части текста | HTML-элемент <noindex> | Такого элемента в документации нет |
| noindex в robots.txt | Директивы нет в справке (есть User-agent, Disallow, Allow, Sitemap, Clean-param) | Не поддерживается |
| Срок появления в поиске по справке | После обхода - в течение двух недель | Сканирование - от нескольких дней до нескольких недель |
| Проверка в выдаче | Оператор url: | Оператор site: |
| Ответы нейросети | Запрет для YandexAdditional и YandexAdditionalBot в robots.txt | Токен Google-Extended в robots.txt: запрет использования для Gemini; на показ в Google Поиске не влияет |
Из таблицы видно главное: настройка «под один поисковик» не закрывает второй. Sitemap и метатеги работают в обоих, а IndexNow, обход по Метрике и элемент <noindex> - только в Яндексе.
Строке про нейросети нужно пояснение. По документации Google о поисковых роботах, токен Google-Extended позволяет запретить использование результатов сканирования для обучения моделей Gemini и для ответов в приложениях Gemini. На показ сайта в Google Поиске он не влияет. Настройки для Googlebot действуют на Google Поиск вместе с «Обзором» и другими его функциями, отдельного токена для них нет.
Раз инструменты разные, отличаются и сроки, которые обещают справки. Их стоит знать, чтобы отличать нормальное ожидание от проблемы.
Сколько времени занимает индексация сайта
По справке Яндекса, после обхода сайта роботом страницы могут появиться в поиске в течение двух недель. Заявка на переобход ждёт в очереди не более трёх дней. Google пишет, что сканирование может занять от нескольких дней до нескольких недель. Яндекс не прогнозирует сроки и не даёт гарантий. Если через две-три недели после публикации и сигнала роботу страницы нет в поиске, это повод искать причину, а не ждать дальше.
Сроки по официальным справкам
Сроки разбросаны по разным страницам справки Яндекса и документации Google. Сводка:
- Новый сайт. После добавления в Вебмастер сайты, как правило, могут появиться в поиске в течение двух недель («Как работает поиск Яндекса»).
- Страницы после обхода - в течение двух недель («Как добавить сайт в поиск»).
- Переобход. Статус «В очереди» длится не более трёх дней, после статуса «Заявка обработана» данные обновятся в течение двух недель («Переобход страниц»).
- Sitemap. Новый файл робот обработает в течение двух недель, а после нажатия кнопки обновления данные загрузятся в течение трёх дней («Файлы Sitemap»).
- Возврат исключённой страницы после исправления - в течение двух недель после того, как робот узнает об изменении («Почему страницы исключены из поиска»).
- Данные в Вебмастере. Статистика обхода обновляется ежедневно, в течение шести часов после посещения роботом («Статистика обхода»). Сведения о новых страницах в разделе «Страницы в поиске» при быстром индексировании могут отставать на несколько дней.
- Google. По документации «Как запросить повторное сканирование», сканирование занимает от нескольких дней до нескольких недель. Справка Search Console об инструменте проверки URL уточняет, что после запроса индексирования обычно требуется порядка суток, но иногда больше. В справке Search Console срок запроса индексирования назван шире: процесс может занять одну-две недели. Единой верхней границы документация Google не называет.

Календарь: что делать по дням
Сроки из справок удобнее держать как календарь. Дни отсчитываются от публикации страницы:
- День 0. Страница опубликована, адрес есть в Sitemap, ссылка на неё стоит на проиндексированной странице, главные адреса отправлены на переобход.
- День 3. Проверить статус заявки в «Переобходе страниц»: «В очереди» по справке длится не более трёх дней. Статус «Ошибка» - повод проверить доступность страницы и отправить заявку заново.
- День 14. Проверить страницу в «Проверке страницы» Вебмастера: после статуса «Заявка обработана» данные обновляются в течение двух недель.
- День 21. Если страницы всё ещё нет в поиске, пройти порядок проверки из раздела «Почему сайт или страница не индексируется». Три недели - граница, которую выбрал автор материала, а не срок из справки.
От чего зависит скорость индексации
Точной формулы скорости индексации поисковики не публикуют. Справками подтверждены факторы, которые мешают или помогают роботу:
- доступность сервера - ошибки и долгие ответы не дают роботу загрузить страницу;
- адрес страницы в Sitemap и ссылки на неё с уже проиндексированных страниц;
- отсутствие запретов в robots.txt и метатегах на нужных страницах;
- отсутствие дублей - робот не тратит обход на копии;
- понятные адреса - по рекомендациям Яндекса по индексированию, большое число параметров, повторяющиеся директории и слишком длинные адреса ухудшают индексирование.
В Вебмастере есть настройка «Индексирование → Скорость обхода». По справке Яндекса, по умолчанию система сама рассчитывает оптимальную скорость. Снижать её стоит, только если робот создаёт заметную нагрузку и растёт время ответа сервера. Перед этим справка советует проанализировать логи и закрыть служебные страницы и дубли в robots.txt.
Понятий «траст», «песочница для молодых доменов» и «дополнительный индекс» в изученных справках Яндекса нет. Если подрядчик объясняет задержку ими, стоит попросить ссылку на первоисточник.
Почему «за минуты» - не норма
В части материалов встречается обещание «от нескольких минут»; ни одна из изученных справок такого срока не называет. Быстрое попадание в поиск бывает у часто обновляемых сайтов, которые робот посещает постоянно. Но обещать его владельцу нового сайта нельзя: официальные справки говорят о днях и неделях.
Граница тревоги: две-три недели после публикации и сигнала роботу (Sitemap, переобход). Если страницы всё ещё нет в поиске, нужно пройти по порядку проверки из раздела о причинах. А чтобы понять, есть страница в индексе или нет, хватит нескольких минут.
Как проверить индексацию сайта и отдельной страницы
Быстро - ввести в поиск Яндекса адрес страницы с оператором url:, а в Google - с оператором site:. Если страница нашлась, она в индексе. Точно - в Яндекс Вебмастере («Индексирование → Проверка страницы» и «Страницы в поиске») и в Google Search Console (инструмент проверки URL и отчёт об индексировании страниц). Операторы показывают не все страницы, поэтому число страниц в индексе берут только из панелей.
Быстрая проверка в поисковой строке
Яндекс. По справке «Сколько страниц сайта в поиске», проверять удобнее в приватном режиме браузера. В строку поиска вводят адрес с оператором (url:https://example.com/page/) или без него. Если страница появилась в результатах, она проиндексирована.
Google. Используют оператор site:: запрос site:https://example.com/page/ покажет, есть ли адрес в индексе. У оператора есть ограничения, о которых пишет документация Google:
- он не всегда возвращает все проиндексированные адреса, особенно на крупных сайтах;
site:https://www.example.comиsite:https://example.com/- разные запросы с разными результатами;- для полноценной проверки Google рекомендует инструмент проверки URL.
Вывод: оператор годится, чтобы проверить одну страницу, но не чтобы посчитать страницы сайта.

Проверка в Яндекс Вебмастере
В Яндекс Вебмастере индексация сайта видна в разделе «Индексирование». Сайт для этого добавляют в сервис и подтверждают права. Дальше нужны четыре инструмента.
- Одна страница - «Индексирование → Проверка страницы». По справке, инструмент показывает код ответа робота, содержимое страницы глазами робота, статус страницы (участвует в поиске или исключена) и адаптацию под мобильные устройства.
- Весь сайт - «Индексирование → Страницы в поиске». Здесь графики новых и удалённых страниц, исключённых страниц и история по разделам. Режимы «Последние изменения», «Все страницы» и «Исключенные страницы» показывают до 50 000 записей каждый (справка «Страницы в поиске»). Общее число страниц в базе видно в столбце «В поиске» списка сайтов аккаунта. В это число входят и страницы, которые остались в базе, но в выдаче не показываются, в том числе после запроса на удаление.
- Важные страницы - «Индексирование → Мониторинг важных страниц». Сюда добавляют ключевые адреса: главную, разделы каталога, страницы услуг. Справка советует настроить уведомления, чтобы быть в курсе изменений в поисковой базе и на важных страницах.
- Обход - «Индексирование → Статистика обхода». Показывает, какие страницы робот обходит и какие не смог загрузить, с датами визитов и кодами ответа. Данные выгружаются в XLS или CSV.
Вебмастер показывает индексирование подробнее, чем любой оператор: не только «есть или нет», но и причину исключения.
Как проверить индексацию сайта в Google
Проверить индексацию сайта в Google можно двумя инструментами Search Console.
Инструмент проверки URL - для одной страницы. По справке Search Console, он возвращает один из четырёх статусов. Это «URL есть в индексе Google», «URL есть в индексе Google, но есть проблемы», «URL нет в индексе Google» и «URL содержит альтернативную версию страницы». Первый статус означает, что страница может показываться в результатах, но это не гарантия показа. Здесь же кнопка «Запросить индексирование».
Отчет об индексировании страниц - для всего сайта. Справка Google показывает, сколько адресов проиндексировано и по каким причинам остальные нет. Как подключить сервис и разобраться в остальных отчётах, подробно описано в статье о том, как добавить сайт в Search Console и читать отчёты.
Как читать статусы: что исправлять, а что норма
Статусы обеих систем звучат тревожно, но действий требуют далеко не все.
- Google: «Страница просканирована, но пока не проиндексирована», «Обнаружена, не проиндексирована», «Страница с переадресацией», «Страница является копией. Канонический вариант не выбран пользователем».
- Яндекс: «малоценная или маловостребованная», дубль, неканоническая, редирект.
Главное правило дают сами справки. Яндекс пишет, что наличие и количество исключённых страниц в Вебмастере не должно влиять на положение сайта в поиске. Google - что не все страницы сайта должны быть проиндексированы: дубли, адреса с параметрами и страницы, закрытые robots.txt или noindex, обычно остаются вне индекса, и это ожидаемо.
На практике: смотреть надо не на общее число исключённых страниц, а на то, есть ли среди них важные. Если важных там нет, индекс в порядке. Если же страниц в поиске нет совсем, сайт нужно сначала правильно представить поисковикам - об этом следующий раздел.
Пример чтения отчёта: что из исключённых страниц чинить
Условный пример: на сайте 120 страниц, 95 из них в поиске, 25 исключено. Исключённых много, но чинить придётся меньше.
| Статус в Вебмастере | Сколько | Что значит | Действие |
|---|---|---|---|
| Редирект | 12 | Старые адреса ведут на новые | Норма |
| Дубль | 8 | Адреса с параметрами повторяют основные | Норма, при необходимости - Clean-param |
| Малоценная или маловостребованная | 3 | Две карточки услуг и одна служебная страница | Две карточки доработать, служебную оставить |
| Ошибка при загрузке (5XX) | 2 | Робот не смог получить страницу | Чинить сервер, отправить на переобход |
Подпись к таблице: условный пример для расчёта, а не данные проекта.
Из 25 исключённых страниц действий требуют четыре, а не двадцать пять. Доля страниц в поиске считается просто: 95 / 120 даёт 79%. Единого «хорошего» процента справки не называют, поэтому сравнивать стоит с важными страницами, а не с общим числом: если все ключевые адреса в поиске, такой показатель не тревожит.
Как проиндексировать сайт в Яндексе и Google: пошагово для нового сайта
Чтобы проиндексировать сайт, его делают доступным роботу и сообщают о нём поисковикам. Открывают нужные страницы в robots.txt, создают файл Sitemap, добавляют сайт в Яндекс Вебмастер и Google Search Console, загружают туда Sitemap и отправляют главные страницы на переобход. По справке «Быстрый старт», добавление в Вебмастер само по себе не гарантирует попадания в поиск, но позволяет следить за индексированием и получать рекомендации по оптимизации и сведения об ошибках.
Шаг 1. Проверить, что сайт открыт для робота
Перед добавлением в панели стоит убедиться в трёх вещах:
- robots.txt не закрывает весь сайт. Строка
Disallow: /часто остаётся после разработки на тестовом домене и блокирует обход целиком. - На страницах нет метатега noindex. Его ставит, в частности, настройка CMS «не индексировать сайт», которую включают на время разработки.
- Главная страница отвечает кодом 200 OK. Справка «Быстрый старт» требует этого для добавления сайта в Вебмастер: допустимо и перенаправление на страницу с кодом 200 OK. А по справке об индексировании ответы 4XX и 5XX исключают страницу из поиска.
Проверить ответ сервера можно в Вебмастере: «Инструменты → Проверка ответа сервера».
Что значит включить индексирование в CMS. У популярных CMS и конструкторов есть настройка, которая запрещает индексацию всего сайта. Её включают на время разработки и забывают снять при запуске. «Включить индексирование» - значит снять этот запрет:
- WordPress. В настройках чтения есть галочка с просьбой к поисковым системам не индексировать сайт. По официальной документации WordPress, с версии 5.3 она добавляет в код страницы метатег robots со значением noindex, nofollow. Документация уточняет, что опция не блокирует доступ к сайту, а учёт просьбы зависит от поисковых систем.
- Tilda. В справке Tilda «Гид по SEO» путь такой: «Настройки сайта» → «SEO» → галочка «Запретить поисковикам индексировать сайт». Чтобы роботы точно не получили доступ к сайту, справка советует поставить на него пароль.
Шаг 2. Настроить параметры индексации: robots.txt, Sitemap и метатеги
Параметры индексации - это набор указаний роботу о том, что обходить, что показывать и что игнорировать. Их четыре:
- robots.txt - правила обхода: какие разделы не посещать (админка, корзина, поиск по сайту).
- Sitemap - список адресов, которые нужно обойти.
- Метатег robots - запрет индексации для отдельной страницы.
- rel=canonical - указание, какую из похожих страниц показывать в поиске.
Минимальный robots.txt по синтаксису справки Яндекса «Использование файла robots.txt» выглядит так:
User-agent: *
Disallow: /admin/
Disallow: /search/
Sitemap: https://example.com/sitemap.xml
Директива User-agent обязательна. Регистр в путях учитывается, в названиях директив - нет. Живой пример настройки - файл robots.txt сайта webgard.ru, он разобран в разделе «Как закрыть страницы от индексации и что такое деиндексация».
Остальные указания - короткие фрагменты кода. Адреса в них условные (example.com).
Минимальный Sitemap по документации Google о создании файла Sitemap - XML-файл с адресом и датой изменения:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://example.com/page/</loc>
    <lastmod>2026-10-06</lastmod>
  </url>
</urlset>
В один файл помещается до 50 000 адресов, размер - до 50 МБ, кодировка - UTF-8. Дату lastmod Google учитывает, только если она точна, а теги priority и changefreq игнорирует. Адрес файла указывают строкой Sitemap в robots.txt, как в примере выше.
Запрет индексации страницы - метатег robots в блоке head. По документации Google о блокировке индексирования, он работает, только если страница не закрыта в robots.txt: иначе робот его не увидит.
<meta name="robots" content="noindex">Основная версия страницы - атрибут canonical, который по документации Google об объединении дублирующихся URL ставят в блоке head. Он указывает адрес, который нужно показывать в поиске:
<link rel="canonical" href="https://example.com/page/">Отдельно нужно выбрать главное зеркало: с www или без, по HTTPS. С остальных вариантов настраивают 301-редирект на основной адрес. По справке «Быстрый старт», сайт добавляют в Вебмастер по одному адресу - с префиксом www или без. Если поисковик видит несколько вариантов адреса с одинаковым содержимым, он получает дубли.
Шаг 3. Добавить сайт в Яндекс Вебмастер и Google Search Console
Добавить сайт в индексацию Яндекса и Google можно через панели, порядок в них одинаковый: войти в аккаунт, добавить адрес сайта, подтвердить права. В Вебмастере права подтверждают HTML-файлом, метатегом в коде главной страницы или записью TXT в DNS. Для записи DNS нужно время на обновление.
Права стоит подтверждать на аккаунт компании, а подрядчику делегировать доступ. По справке, права можно делегировать другим пользователям. Так история данных остаётся у бизнеса при смене исполнителя.
После подтверждения загружают Sitemap: в Вебмастере - «Индексирование → Файлы sitemap», в Search Console - через отчёт о файлах Sitemap. Небольшому сайту, по документации Google о Sitemap, файл не критичен: сайту до 500 страниц с хорошей внутренней перелинковкой Sitemap может не понадобиться. Но для новых сайтов с малым числом внешних ссылок Sitemap полезен.
Шаг 4. Подключить обход по счётчику Метрики
Этот шаг есть только у Яндекса. По справке «Индексирование сайта с помощью счетчика Метрики» порядок такой:
- В Вебмастере открыть «Настройки → Привязка к Яндекс Метрике» и указать номер счётчика.
- Подтвердить привязку. Если сайтом и счётчиком владеет один человек, запрос подтверждается автоматически.
- Включить обход в разделе «Индексирование → Обход по счетчикам».
Если счётчика на сайте ещё нет, начать стоит с того, чтобы установить счётчик Метрики и настроить цели. Он пригодится не только для индексации, но и для оценки заявок с сайта.
Как проиндексировать страницу в Яндексе
Для новой или обновлённой страницы есть раздел «Индексирование → Переобход страниц»: адреса вставляют в поле и отправляют. По справке «Переобход страниц», количество адресов ограничено: лимит общий для основного домена и всех поддоменов и обновляется ежедневно. Для регулярной передачи большого числа страниц справка советует обход по счётчикам Метрики.
Вторая половина работы - ссылка на новую страницу с уже проиндексированной: с главной, из раздела каталога или ленты блога. Справка Яндекса называет доступные ссылки с ранее проиндексированных страниц одним из условий появления страницы в поиске.
Как быстро проиндексировать страницу: отправить её на переобход и поставить ссылку с проиндексированной. В Google то же действие выполняют через инструмент проверки URL и кнопку «Запросить индексирование».
Как быстро проиндексировать сайт: 6 действий в первый день
- Проверить robots.txt и убрать
Disallow: /, если он остался после разработки. - Создать Sitemap и указать его адрес в robots.txt.
- Добавить сайт в Яндекс Вебмастер и подтвердить права на аккаунт компании.
- Добавить сайт в Google Search Console и подтвердить права.
- Загрузить Sitemap в обе панели.
- Привязать счётчик Метрики и включить обход по счётчикам.
Сайт представлен поисковикам. Дальше вопрос в том, как ускорить индексацию новых страниц и какие советы из интернета время только отнимают.
Как ускорить индексацию сайта: что работает, а что нет
Ускоряют индексацию сигналы роботу и отсутствие помех. Это переобход страниц в Вебмастере, актуальный Sitemap, обход по счётчику Метрики, протокол IndexNow для Яндекса, ссылки на новую страницу с проиндексированных и стабильный ответ сервера. Не ускоряют отправка всех страниц сайта подряд (IndexNow рассчитан на новые, изменённые и удалённые страницы) и увеличение числа запросов: Google прямо пишет, что это не ускоряет индексирование.
5 способов ускорить индексацию сайта в Яндексе
1. Переобход страниц. Подходит для нескольких важных адресов. По справке «Переобход страниц», у заявки три статуса:
- «В очереди» - робот посетит адреса в приоритетном порядке при следующем обращении к сайту, процесс занимает не более трёх дней;
- «Заявка обработана» - робот посетил страницу, данные обновятся в течение двух недель;
- «Ошибка» - робот не смог проиндексировать страницу и обновить информацию о ней: нужно проверить её доступность и скорость ответа сервера и отправить заново.
Справка прямо оговаривает: «Заявка обработана» значит, что робот побывал на странице, а не что она уже в поиске. Типичная ошибка - увидеть этот статус и решить, что работа закончена. Проверять результат нужно через две недели в «Проверке страницы».
Отправлять на переобход не нужно robots.txt (он переобходится автоматически в течение нескольких часов), фавиконку (вместо неё отправляют главную страницу) и Sitemap (для него есть свой раздел).

2. Актуальный Sitemap. После изменений файл не нужно удалять и добавлять заново: по справке «Файлы Sitemap», робот регулярно проверяет его сам. Кнопка обновления запускает обработку в течение трёх дней, пользоваться ею можно до 10 раз для одного хоста.
3. Обход по счётчикам Метрики. Подходит для регулярной передачи большого числа страниц: робот получает адреса из данных счётчика. Настройка описана в пошаговой инструкции выше.
4. IndexNow. Протокол автоматически сообщает поисковику о новых, изменённых и удалённых страницах. По справке Яндекса об IndexNow, для работы нужен ключ, размещённый на сайте и передаваемый в каждом запросе. Один адрес отправляют запросом GET, несколько - запросом POST, для популярных CMS есть плагины.
Ключ - это 8-128 символов (латинские буквы, цифры, дефис) в текстовом файле, который лежит в корне сайта. Имя файла совпадает с ключом, а внутри только сам ключ (справка о ключе). Запрос на один адрес по справочнику API IndexNow выглядит так:
https://yandex.com/indexnow?url=https://example.com/new-page/&key=a1b2c3d4e5f6a7b8Файл с этим ключом должен открываться по адресу https://example.com/a1b2c3d4e5f6a7b8.txt. Справка оговаривает три вещи:
- способ не гарантирует, что переданные страницы будут проиндексированы;
- сообщать нужно только об изменившихся, новых и удалённых страницах;
- небольшим сайтам вместо IndexNow можно использовать «Переобход страниц».
5. Ссылки с проиндексированных страниц. Новая страница должна быть доступна по ссылке из меню, раздела или блока новых материалов. Специального инструмента, который ускорял бы учёт ссылок, в справках Яндекса нет: робот находит страницу по ссылке при обычном обходе.
Что ускоряет индексацию в Google
В Google рабочих инструментов два:
- Sitemap - для большого числа адресов;
- инструмент проверки URL и кнопка «Запросить индексирование» - для отдельных страниц.
По документации «Как запросить повторное сканирование», на запросы по отдельным адресам действуют квоты, а увеличение числа запросов не ускорит индексирование. Там же сказано, что для сайтов на WordPress, Blogger и похожих платформах поисковые системы в большинстве случаев находят новый контент автоматически.
Техника, от которой зависит действие сигналов
Сигнал роботу не сработает, если робот не может загрузить страницу. Перед тем как ускорять индексацию, стоит проверить:
- сервер отвечает быстро и стабильно - ошибки и слишком долгие ответы дают статус «Ошибка» в переобходе;
- заголовок Last-Modified отдаёт корректную дату последнего изменения документа, а сервер правильно отвечает на запрос If-Modified-Since - об этом просят рекомендации Яндекса по индексированию. Без заголовка сайт всё равно индексируется, но изменившиеся страницы переиндексируются реже. Ответ на If-Modified-Since проверяют в «Проверке страницы»: там есть поле для даты;
- несуществующие страницы отдают 404, а доступные - 200 OK;
- дубли и служебные страницы закрыты - робот не тратит на них обход;
- скорость обхода в Вебмастере не занижена без причины.
Чего нет в справках Яндекса и Google
«Пинг-сервисы», «дополнительный индекс», «песочница для молодых доменов», «платная быстрая индексация» - в изученных справках Яндекса и Google таких инструментов и терминов нет.
Для руководителя: подрядчик, который обещает «индексацию за час за деньги», продаёт то, что поисковик делает по своему расписанию: Google прямо пишет, что не берёт плату за более частое сканирование. В приёмке такой работы стоит требовать не обещание срока, а список отправленных на переобход адресов и их статус через две недели.
Но бывает, что все сигналы поданы, а страницы в поиске так и нет. Тогда дело не в скорости, а в причине, которую нужно найти.
Почему сайт или страница не индексируется: причины и что делать
Чаще всего страница не попадает в индекс по одной из пяти причин. Это запрет в robots.txt или метатеге noindex, ошибка сервера (3XX, 4XX, 5XX), дубль или неканонический адрес, низкая ценность страницы или нарушения на сайте. Причину конкретной страницы Яндекс показывает в Вебмастере («Индексирование → Страницы в поиске → Исключенные страницы»), Google - в отчёте об индексировании страниц.
Причины исключения из поиска Яндекса и что делать
Исключённые страницы - не приговор. Дубли, редиректы и неканонические адреса и должны быть исключены: так поисковик убирает копии. Чинить нужно ошибки сервера, случайные запреты и важные страницы, которые оказались в «малоценных». После исправления страницу отправляют на переобход, и, по справке, она может вернуться в поиск в течение двух недель после того, как робот узнает об изменении.
Справка «Почему страницы исключены из поиска» называет восемь причин. Таблица ниже показывает, что каждая значит и какие из них - норма.
| Причина в Вебмастере | Что это значит | Что делать | Норма или чинить |
|---|---|---|---|
| Малоценная или маловостребованная | Алгоритм видит у страницы мало шансов быть востребованной в поиске | Решить, нужна ли страница в поиске; если нужна - доработать содержание, если нет - закрыть | Чинить, если это важная страница |
| Ошибка при загрузке или обработке (3XX, 4XX, 5XX) | Робот не смог получить страницу | Проверить ответ в «Проверке ответа сервера», убедиться, что адрес есть в Sitemap | Чинить |
| Запрет в robots.txt или noindex | Страница закрыта от индексации | Убрать запрет, если он случайный; если запрет не ставили - обратиться к хостинг-провайдеру или регистратору, проверить срок регистрации домена | Чинить, если запрет случайный |
| Редирект | Страница перенаправляет на другой адрес | Убедиться, что перенаправление нужно | Норма |
| Дубль | Содержимое совпадает с другой страницей | Склеить дубли 301-редиректом, canonical или Clean-param | Норма для служебных копий, чинить для важных страниц |
| Неканоническая | В canonical указан другой адрес | Проверить, что canonical ведёт туда, куда нужно | Норма, если canonical верный |
| Адрес признан неглавным (зеркало) | Сайт объединён в группу зеркал, в поиске другой адрес | Проверить группу зеркал, разделить, если объединение ошибочное | Норма, если главное зеркало выбрано верно |
| Нарушения на сайте | Найдены нарушения правил поиска или угрозы | Открыть «Оптимизация сайта → Безопасность и нарушения», устранить нарушение | Чинить |
Таблица отвечает на главный вопрос владельца, увидевшего в Вебмастере тысячи исключённых страниц. Среди них нередко много редиректов, дублей и неканонических адресов, то есть страниц, которых в поиске и не должно быть. Тревожиться стоит из-за строк с меткой «Чинить».
«Малоценная или маловостребованная»: что это значит
Это частый и непонятный статус. По справке Яндекса о малоценных страницах, малоценная страница - дубль или страница без видимого роботу содержимого. Маловостребованная - страница, которую алгоритм оценил как маловероятную к показу по запросам на позициях, где её смогут найти.
Три важные детали из справки:
- действия алгоритма - не ограничения для сайта в поиске и не наказание;
- решение пересматривается регулярно, релевантность может меняться даже при неизменном содержимом;
- в поиск могут не попасть почти одинаковые карточки товаров, отличающиеся цветом или размером, страницы пагинации и сравнения, страницы-картинки без текста (перечень - в справке «Почему страницы исключены из поиска»).
Что делать владельцу: решить, нужна ли страница в поиске. Если нужна - сделать её отличной от соседних и полезной: добавить описание, характеристики, ответы на вопросы, улучшить заголовок. Если не нужна - закрыть от индексации или склеить с основной.
Одна из причин «сайта нет в поиске» после запуска - запрет из настроек CMS. Как снять его в WordPress и Tilda, описано в шаге 1 выше.
Если запрет в robots.txt владелец не ставил сам, справка Яндекса советует обратиться к хостинг-провайдеру или регистратору. Там же отдельный пункт: проверить, не заблокирован ли домен из-за истечения срока регистрации.
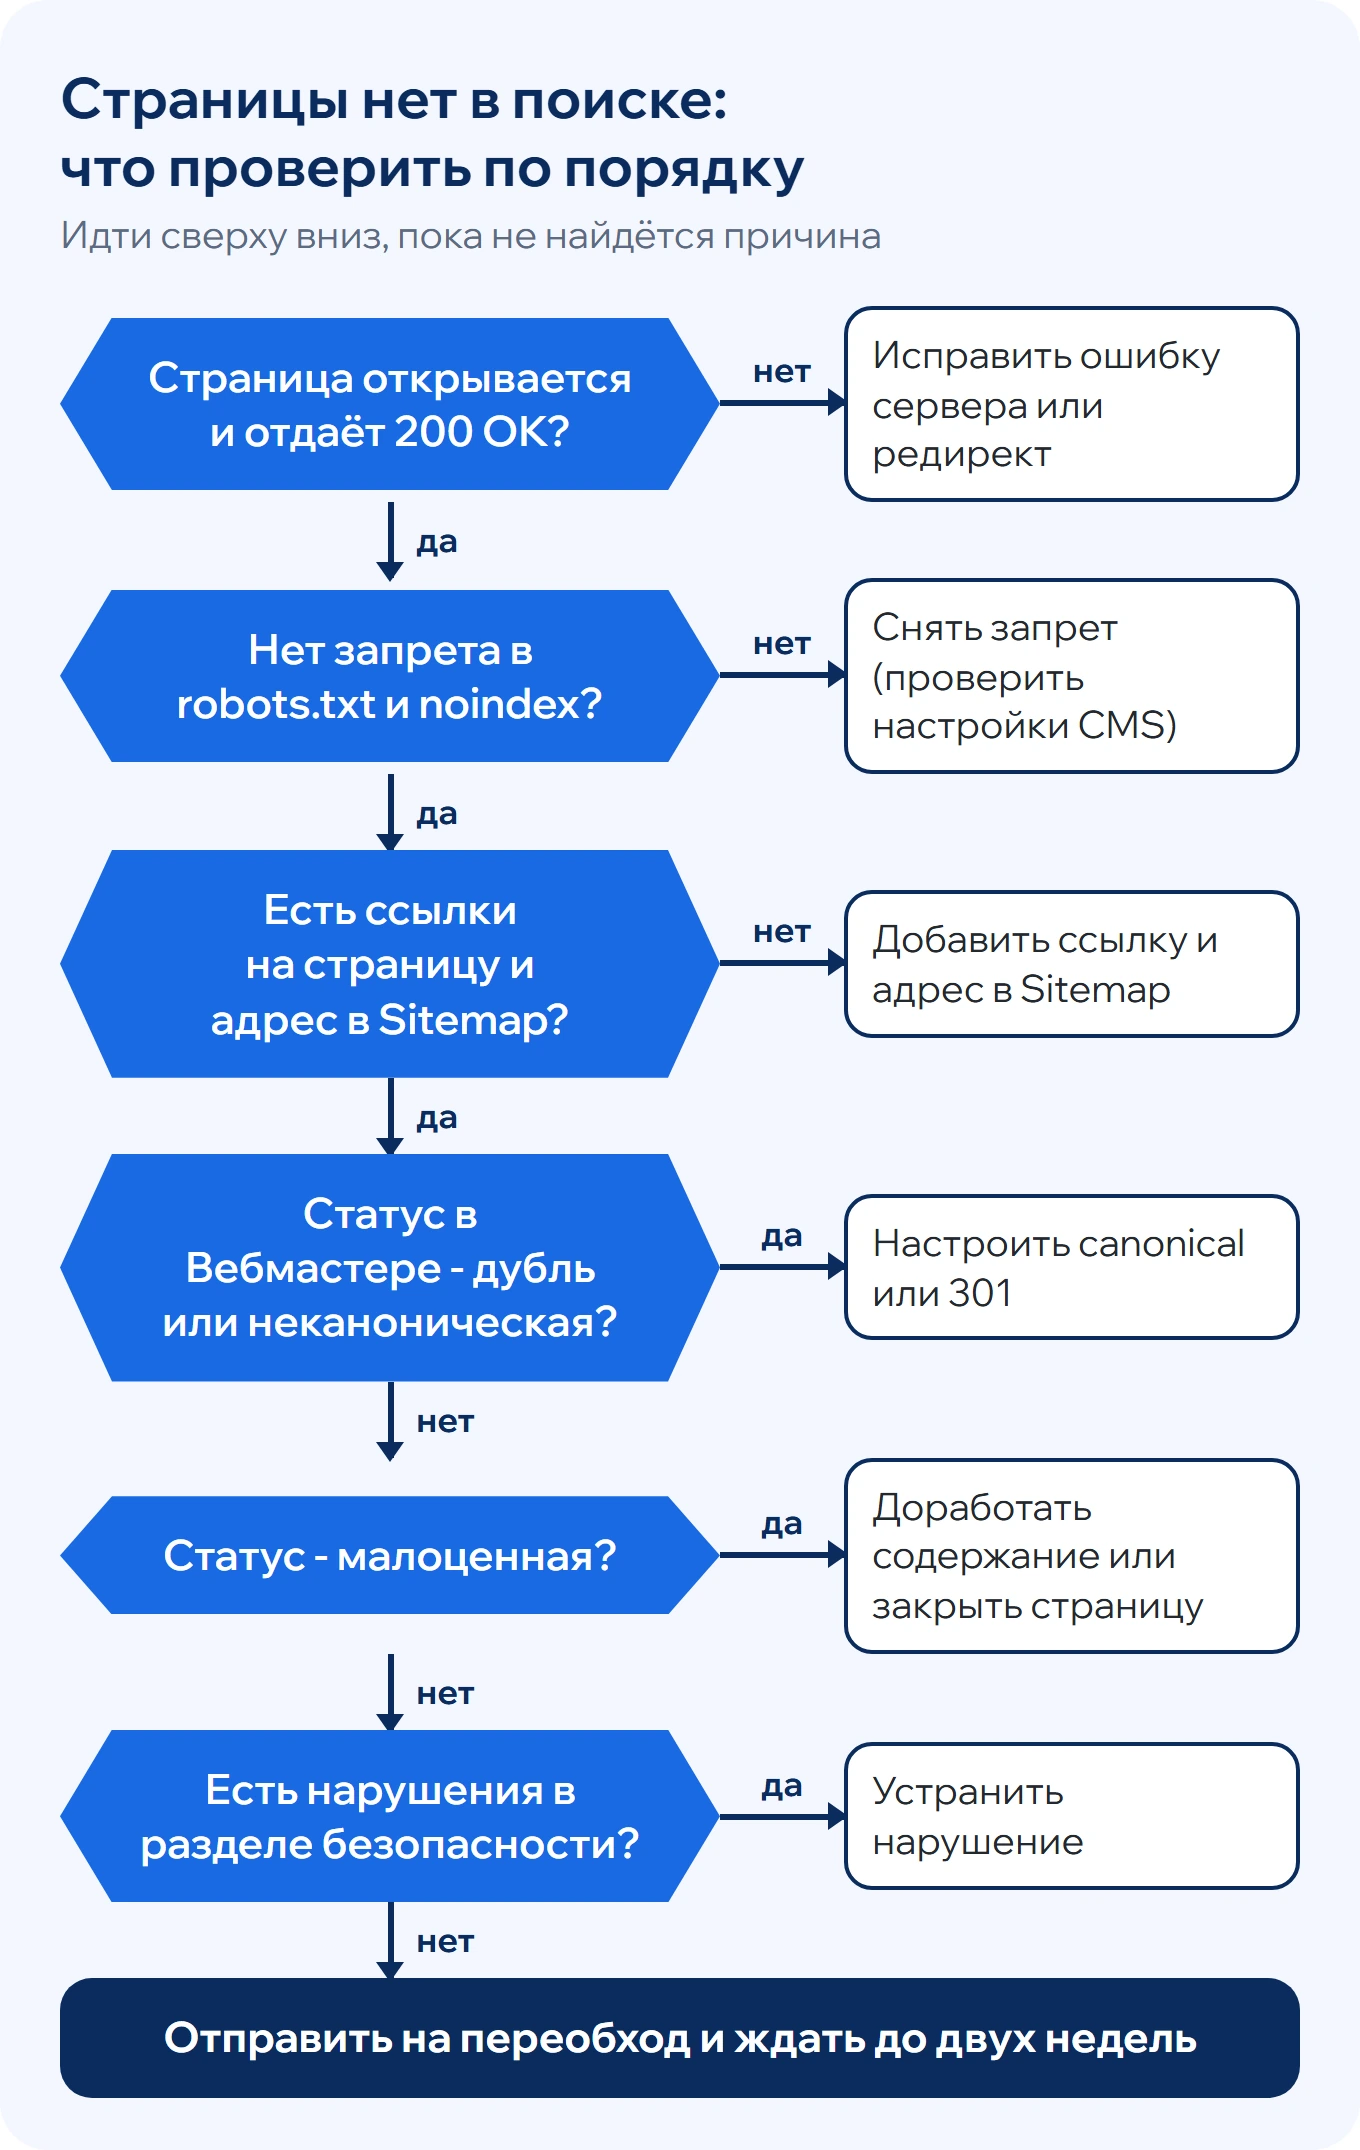
Страница пропала из поиска: порядок проверки
Когда важная страница выпала из поиска, проверку удобнее вести по порядку - от простого к сложному:
- Открывается ли страница и что отдаёт сервер. В Вебмастере - «Инструменты → Проверка ответа сервера», в Google - инструмент проверки URL.
- Нет ли запрета. robots.txt, метатег noindex, настройка CMS; синтаксис файла проверяет «Инструменты → Анализ robots.txt».
- Есть ли ссылки на страницу и её адрес в Sitemap. Ссылки с проиндексированных страниц и адрес в Sitemap - то, по чему робот узнаёт о странице.
- Не стала ли страница дублем или неканонической: статус виден в «Страницах в поиске» Вебмастера и в отчёте Google.
- Не малоценная ли она: такой статус Вебмастер показывает в тех же «Страницах в поиске».
- Нет ли нарушений в разделе «Оптимизация сайта → Безопасность и нарушения».
После этого - исправить, отправить на переобход и ждать до двух недель.
Отдельная ловушка: в браузере страница открывается, а в Вебмастере числится ошибкой. Справка Яндекса объясняет, что ответ браузеру может отличаться от ответа роботу. При этом и сам инструмент «Проверка ответа сервера» обращается к сайту с другого IP-адреса, поэтому настоящий ответ роботу сверяют по логам сервера.
Если причин несколько, сайт крупный или проблема появилась после переезда, разбор превращается в отдельную работу. Её выполняют в составе технического SEO-аудита: специалисты проверяют индексацию вместе со структурой, дублями и ответами сервера.
Индексация при переезде, редизайне и смене CMS
Перенос сайта - момент, когда индекс легко потерять. Поисковик видит новые адреса как новые страницы, а старые должны вести на них постоянными перенаправлениями.
Если меняется адрес сайта (домен, доменная зона, www, HTTP на HTTPS), порядок по справке Яндекса «Переезд сайта» такой:
- Добавить в Яндекс Вебмастер оба адреса и подтвердить на них права.
- Проверить доступность сайта по новому адресу.
- Настроить перенаправление со старого адреса на новый.
- Отправить заявку в разделе «Индексирование → Переезд сайта». Справка пишет, что это ускорит переезд и выявит возможные ошибки.
Ход переезда виден в разделе «Страницы в поиске»: старые адреса постепенно исчезают, новые появляются.
В Google для смены домена или субдомена есть инструмент «Изменение адреса» (справка Search Console). Он не подходит для перехода с HTTP на HTTPS, с www на адрес без www и для переноса без смены адресов. Перед запросом инструмент проверяет права на оба сайта и наличие редиректов 301 на нескольких страницах старого сайта.
Если меняется только CMS или дизайн, а адреса остаются прежними, переносить нечего, но сломать можно многое. На новой платформе стоит проверить ответы сервера, robots.txt, canonical и настройку «не индексировать сайт», оставшуюся от разработки.
Если адреса меняются, помогает руководство Google о переносе сайта с изменением URL:
- составить список старых адресов и соответствие новым;
- настроить постоянные серверные перенаправления без цепочек;
- отправить в Search Console новый Sitemap. На время переноса Google советует держать и файл со старыми адресами: по ним видно, как число проиндексированных страниц переходит со старого сайта на новый;
- переносить в период минимального трафика и по частям, если сайт большой.
Google предупреждает: для сайта среднего размера перенос занимает несколько недель или больше, позиции в это время могут быть нестабильными. После запуска стоит проверить ответы старых адресов и динамику в «Страницах в поиске» и в отчёте об индексировании.
Индексация в проектах Webgard
В кейсах Webgard настройка корректной индексации стоит в списке работ по продвижению рядом с аудитом, структурой по семантическому ядру и редизайном. Так было в кейсе оптового интернет-магазина opttop24. Пункт «Настроили корректную индексацию» стоит там в списке работ вместе с полным редизайном со сменой CMS, аудитом, структурой по семантическому ядру и наращиванием ссылочной массы. Переходы из поисковых систем в этом проекте выросли с 500 до 4600. В кейсе результат подписан «С 500 до 4600», показатель - «Рост переходов из поисковых систем».
Тот же пункт стоит в списках работ ещё четырёх кейсов. Результаты в таблице приведены дословно, как в кейсах. Рост в каждом проекте дал весь комплекс работ, а не индексация сама по себе.
| Сайт | Отрасль | Результат из кейса | Рядом в списке работ |
|---|---|---|---|
| opttop24.ru | Оптовые продажи товаров | «С 500 до 4600», «Рост переходов из поисковых систем» | полный аудит, редизайн со сменой CMS, ссылочная масса |
| novusparts.ru | Запчасти для спецтехники | «в 3,5 раз», «Вырос поисковый трафик за все время сотрудничества» | полный аудит, редизайн со сменой CMS, ссылочная масса |
| optomnado.ru | Оптовые продажи товаров | «в 1,5 раза», «Рост переходов из поисковых систем» | полный аудит, частичный редизайн, новые посадочные страницы |
| svoydoctor-spb.ru | Ветеринарная клиника | «в 6 раз», «Вырос поисковый трафик за все время сотрудничества» | полный аудит, переработка посадочных страниц, ссылочная масса |
| divanmaster.ru | Ремонт и изготовление мягкой мебели | «в 14 раз», «Вырос поисковый трафик за все время сотрудничества» | полный аудит, частичный редизайн, блог со статьями |
Индексация в этом комплексе - условие, а не причина роста: страницы, которых нет в базе, трафика из поиска не приносят.
Найти и убрать лишние страницы из индекса - вторая половина той же задачи. Об этом следующий раздел.
Как закрыть страницы от индексации и что такое деиндексация
От индексации закрывают служебные, дублирующие и личные страницы: корзину, личный кабинет, результаты поиска по сайту, страницы сортировки и фильтров с параметрами. Закрывают директивой Disallow в robots.txt, метатегом robots с noindex или авторизацией. Обратный процесс - исключение страницы из индекса - называют деиндексацией. Ускорить её в Яндексе можно инструментом «Удаление страниц из поиска».
Какие страницы закрывать от индексации
По справкам Яндекса, в поиске не нужны:
- служебные и технические страницы - админка, корзина, оформление заказа, личный кабинет;
- результаты поиска по сайту - они дублируют содержимое каталога;
- адреса с идентификаторами сессий и незначащими GET-параметрами - для них в Яндексе есть директива Clean-param;
- дубли - для них лучше склейка 301-редиректом или canonical, чем запрет;
- страницы с конфиденциальными данными - их закрывают авторизацией, а не robots.txt.
Robots.txt, noindex или пароль: что выбрать
Сначала - какой инструмент под какую задачу:
| Задача | Что использовать | Чего не делать |
|---|---|---|
| Убрать страницу из поиска | Метатег noindex или заголовок X-Robots-Tag | Не закрывать её одновременно в robots.txt: робот не увидит noindex |
| Не тратить обход на служебные разделы | Disallow в robots.txt | Не рассчитывать, что это уберёт страницу из выдачи |
| Убрать дубль | 301-редирект или canonical | Не закрывать запретом |
| Скрыть приватное | Пароль или код 403 | Не полагаться на robots.txt |
| Удалить страницу навсегда | Код 404 или 410 | Не полагаться только на robots.txt |
Заголовок X-Robots-Tag нужен для файлов, где метатег поставить нельзя: по документации Google, так закрывают PDF, видео и изображения. Он отправляется в ответе сервера:
X-Robots-Tag: noindexКлючевая ловушка: robots.txt запрещает обход, но не всегда убирает страницу из выдачи.
- Google. По документации о блокировке индексирования, если страница закрыта в robots.txt, робот не увидит на ней noindex. Документация по robots.txt добавляет: заблокированная страница может попасть в индекс, если на неё ссылаются другие сайты, и показываться в выдаче - возможно, с текстом ссылки вместо описания.
- Яндекс. По справке о запрете индексирования, если главная страница запрещена в robots.txt, но на неё ведут ссылки с других сайтов, она может попасть в результаты поиска. Для скрытия главной справка рекомендует авторизацию. Справка о robots.txt уточняет: чтобы убрать страницы из поиска, указывают noindex в метатеге или HTTP-заголовке и не ограничивают их в robots.txt.
Правило выбора для владельца:
- убрать страницу из поиска - метатег noindex, и не закрывать её одновременно в robots.txt, пока она не выпадет из индекса;
- не тратить обход робота на служебное - robots.txt;
- закрыть по-настоящему - пароль или коды ответа 403, 404, 410.
Как это выглядит на работающем сайте, видно по файлу robots.txt сайта webgard.ru.

User-agent: *
Disallow: /wp-admin/
Disallow: /message/
Disallow: /category/
Disallow: /author/
Disallow: *?
Disallow: /wp-json/
Disallow: */feed/
Allow: /*.css
Allow: /*.js
Allow: /wp-includes/*.js
Allow: /wp-includes/*.css
Allow: /wp-content/*.js
Allow: /wp-content/*.css
Allow: /*.eot
Allow: /*.svg
Allow: /*.ttf
Allow: /*.woff
Allow: /*.jpg
Allow: /*.png

Sitemap: https://webgard.ru/sitemap_index.xml
В этом файле служебные разделы WordPress, архивы рубрик и авторов, RSS-ленты и все адреса с параметрами закрыты от обхода. Стили, скрипты, шрифты и картинки открыты явно, чтобы робот видел страницы так же, как посетитель. Последняя строка указывает роботу путь к карте сайта.
Правило Disallow: *? закрывает от обхода все адреса с параметрами. Сайту, где нужные в поиске страницы открываются с параметрами (фильтры каталога, пагинация), оно не подойдёт: вместе с мусором закроются и полезные адреса. Для Яндекса мягче директива Clean-param, для дублей подходит canonical.
Крупный сайт и интернет-магазин: фильтры, параметры, лимит сканирования
Интернет-магазин может порождать тысячи адресов: фильтры, сортировки, метки рекламы. Для таких сайтов важны четыре вещи.
Лимит сканирования. Подрядчики нередко объясняют задержку «краулинговым бюджетом». По руководству Google о лимите сканирования, этим нужно заниматься в основном владельцам крупных сайтов. Это сайты от 1 млн страниц с еженедельными изменениями и от 10 тыс. страниц с ежедневными. Если подрядчик ссылается на бюджет, стоит спросить, сколько страниц на сайте. Для небольшого сайта сначала нужно пройти порядок проверки из раздела о причинах.
Параметры в адресах. Фильтры и сортировки дают адреса, которые повторяют содержимое каталога. В Яндексе для них есть директива Clean-param. По справке о ней, робот сводит такие адреса к одному, и Яндекс рекомендует её вместо Disallow: директива передаёт основному адресу накопленные показатели.
User-agent: Yandex
Clean-param: sort&ref /catalog/
Параметры sort и ref робот не учитывает в адресах, которые начинаются с /catalog/. Параметры отслеживания вроде utm_source и ysclid поисковая система, по справке, может отбросить сама, а Вебмастер пометит такие адреса как исключённые директивой Clean-param. Если страница фильтра отвечает на отдельный поисковый запрос, закрывать её параметры нельзя.
Пагинация и почти одинаковые карточки. Такие страницы алгоритм Яндекса может не включить в поиск. Причины и действия - в подразделе о статусе «малоценная или маловостребованная».
Сайты на скриптах. В «Проверке страницы» Вебмастер показывает, как выглядит содержимое страницы для робота. Если у робота пусто или не хватает блоков, которые видит посетитель, возможная причина - отображение скриптов. Для таких страниц в Вебмастере есть отдельный раздел «Индексирование → Рендеринг страниц JavaScript».
Деиндексация: как удалить страницу из поиска
Индексация наоборот называется деиндексацией - это исключение страницы из индекса. Термин из практики SEO; в справках Яндекса и Google процесс называют удалением страниц из поиска.
В Яндексе порядок по справке «Как удалить страницы из поиска» такой:
- Сделать страницу недоступной (код 404, 403 или 410) или закрыть её директивой Disallow либо метатегом noindex.
- Открыть «Инструменты → Удаление страниц из поиска» и отправить адреса.
- Страницы удаляются в течение суток после проверки роботом.
Лимиты: до 500 адресов одного сайта в сутки и до 20 префиксов в сутки. Если запреты потом снять, возвращение страниц в поиск может занять до трёх недель.
В Google удаление через Search Console временное. По справке об удалении URL, страница скрывается на срок до шести месяцев и продолжает сканироваться. Для постоянного результата нужны код 404 или 410, пароль или noindex; полагаться только на robots.txt справка не советует.
Как запретить показ сайта в ответах Алисы AI
В справке Яндекса о запрете индексирования на 06.10.2026 есть отдельный раздел про Алису AI. Чтобы ограничить показ содержимого сайта в её ответах, в robots.txt ставят запрет для роботов YandexAdditional или YandexAdditionalBot. Пример из справки:
User-agent: YandexAdditionalBot
Disallow: /cats/mycat.html
Изменение учитывается по мере обновления поисковых данных, в течение 2-14 дней. По справке о роботах Яндекса, YandexAdditional и YandexAdditionalBot индексирующих запросов не делают, а основным индексирующим роботом остаётся YandexBot. Закрывать сайт от нейроответов или нет - решение бизнеса; важно знать, что такая настройка существует.
С индексацией сайтов разобрались. Осталось слово «индексация» в других значениях, которые часто попадают в те же запросы.
Чек-лист: как держать индексацию сайта под контролем
Раз в месяц достаточно пяти проверок: ошибки в Вебмастере и Search Console, число исключённых страниц, наличие важных страниц в поиске, актуальность Sitemap и случайные запреты в robots.txt. После крупных изменений сайта - переезда, смены CMS, редизайна - те же проверки нужны сразу.
- Сайт добавлен в Яндекс Вебмастер и Google Search Console, права подтверждены на аккаунт компании, а не только подрядчика.
- Важные страницы добавлены в «Мониторинг важных страниц», уведомления включены.
- Раз в месяц просмотрен график исключённых страниц. По справке «Страницы в поиске», резкое изменение числа страниц может быть связано с изменениями на сайте - сменой структуры или robots.txt.
- robots.txt не закрывает нужные разделы - это проверяет «Анализ robots.txt».
- Раздел «Диагностика сайта» в Вебмастере просмотрен: новых проблем нет.
- Sitemap обновляется автоматически и не содержит удалённых и закрытых адресов.
- Новые страницы получают ссылку с проиндексированной страницы и отправляются на переобход.
- После переезда, смены CMS или редизайна проверены ответы сервера по старым адресам и настроены 301-редиректы (порядок - в подразделе «Индексация при переезде, редизайне и смене CMS»).
- Отчёт подрядчика по индексации содержит числа: сколько страниц в поиске, сколько исключено, по каким причинам и что исправлено.
Для руководителя: в приёмке работ по индексации стоит просить не фразу «индексация в порядке», а выгрузку «Страниц в поиске» и список исправленных причин с датами. Такой отчёт можно проверить, а общую фразу - нет.
Что должно быть в отчёте подрядчика по индексации:
- дата отчёта и дата выгрузки из Вебмастера и Search Console;
- сколько страниц в поиске и сколько исключено, в сумме и по причинам;
- какие важные страницы из «Мониторинга важных страниц» не участвуют в поиске;
- что исправлено и когда;
- какие адреса отправлены на переобход и какой статус у них через две недели.
Красные флаги: обещание индексации «за час», платная «ускоренная индексация», «песочница» или пинг-сервисы как объяснение задержки, отчёт без чисел. Ещё один флаг - права на Вебмастер и Search Console, оформленные только на подрядчика.
Задача разработчику перед запуском:
- снять запрет индексации в настройках CMS;
- убрать
Disallow: /из robots.txt; - добиться кода 200 OK на главной;
- настроить 301-редирект на главное зеркало;
- сформировать Sitemap и указать его в robots.txt.
Частые вопросы об индексации сайта
Индексация сайта: что это такое простыми словами?
Это внесение страниц сайта в базу поисковой системы. Робот находит страницу, читает её и сохраняет в индекс. Без этого страницу нельзя найти в поиске, какой бы полезной она ни была.
Проиндексировать - это что означает простыми словами?
Внести страницу в базу поисковой системы. После этого страницу можно найти в Яндексе или Google, но высокие позиции это не гарантирует: место в выдаче определяет ранжирование.
Сколько по времени индексируется сайт в Яндексе?
По справке Яндекса, после обхода роботом страницы могут появиться в поиске в течение двух недель. Как быстро индексируется сайт в Яндексе, зависит от того, известен ли он роботу и поданы ли сигналы: Sitemap, переобход, обход по счётчику Метрики.
Как проверить индексацию сайта в Google?
Проверить индексацию сайта в гугл для одной страницы можно оператором site: и адресом, а точнее - инструментом проверки URL в Search Console. Число страниц в индексе берут из отчёта об индексировании страниц: оператор site: показывает не все адреса.
Почему страница проиндексирована, но её не найти по запросу?
Индекс не равен позиции. Страница может быть в базе, но не отвечать на запрос или проигрывать конкурентам по релевантности, полезности и удобству - по этим признакам Яндекс формирует результаты.
Как называется индексация наоборот?
Деиндексация - исключение страницы из индекса. В справках Яндекса и Google процесс называют удалением страниц из поиска. В Яндексе для этого есть инструмент «Удаление страниц из поиска».
Нужно ли платить за индексацию сайта?
В справках Яндекса и Google платной индексации нет. Google прямо пишет, что не берёт плату за более частое сканирование. Платными бывают только работы специалистов по настройке сайта.
Что делать, если исключённых страниц больше, чем страниц в поиске?
Сначала посмотреть причины. По справке Яндекса, количество исключённых страниц само по себе не должно влиять на положение сайта. Важно другое - нет ли среди исключённых страниц, которые должны приносить трафик.
Влияет ли IndexNow на индексацию в Google?
Нет. Google не входит в число систем, поддерживающих протокол: на indexnow.org на 06.10.2026 названы Bing, Naver, Seznam.cz, Yandex и Yep. Для Google работают Sitemap и инструмент проверки URL.
Индексация и ИКС - одно и то же?
Нет. ИКС - показатель Яндекса, который оценивает весь сайт. Индексация - попадание отдельных страниц в поисковую базу.
Нужно ли отправлять на переобход каждую новую статью?
Не обязательно. Для регулярной передачи изменений справка Яндекса советует Sitemap и обход по счётчику Метрики, а переобход подходит для нескольких важных адресов. Google пишет, что для WordPress, Blogger и похожих платформ новый контент в большинстве случаев находится автоматически.
Почему оператор site: показывает не столько страниц, сколько Вебмастер?
Оператор не всегда возвращает все проиндексированные адреса, особенно на крупных сайтах, об этом предупреждает документация Google. Число страниц в индексе берут из отчётов Вебмастера и Search Console, а не из оператора.
Что делать с индексацией после переезда сайта?
Настроить 301-редиректы со старых адресов на новые, сообщить о переезде в Вебмастере и Search Console и следить за «Страницами в поиске». Порядок описан в подразделе «Индексация при переезде, редизайне и смене CMS».
Индексация в других значениях: Windows, ВКонтакте, экономика
Что означает слово индексация в общем смысле? Составление указателя для быстрого поиска, поэтому слово встречается не только в SEO. В Windows «индексировать содержимое файлов» - разрешить системе заранее составить указатель по тексту внутри файлов, чтобы поиск на компьютере работал быстрее. В экономике индексация - повышение выплат с учётом роста цен. К индексации сайта в поисковиках оба значения отношения не имеют.
Что значит «индексировать содержимое файлов» в Windows
По справке Microsoft «Индексирование поиска в Windows», индексирование создаёт индекс файлов и их свойств на устройстве, а справка сравнивает его с указателем в книге. По умолчанию индексируются свойства файлов, включая имена и полные пути, а для текстовых файлов - и содержимое. Работа идёт в фоне.
Разрешить системе индексировать содержимое файлов - значит позволить ей учитывать при поиске не только имена и свойства, но и текст внутри файлов. Справка приводит наглядный пример: с готовым индексом поиск музыки по слову занимает долю секунды, без индекса - несколько минут. Индекс, как правило, занимает менее 10% размера проиндексированных файлов.
Индексация во ВКонтакте
Что такое индексация в ВК? Так в разговорах владельцев называют видимость страницы или сообщества ВКонтакте в поисковых системах. Видимость зависит от настроек приватности самой страницы. Надписи в настройках сети меняются, поэтому актуальный порядок стоит сверять в справке ВКонтакте.
Индексация в экономике и информатике
В экономике индексация - повышение выплат пропорционально росту цен: зарплат, пенсий, пособий. Для зарплат она закреплена в статье 134 Трудового кодекса РФ: обеспечение повышения уровня реального содержания заработной платы включает её индексацию при росте потребительских цен.
В информатике и библиотечном деле индексирование - это описание документа ключевыми словами или кодами для информационного поиска. Особенность индексного поиска информации в том, что он идёт по заранее составленному указателю, а не перебором всех документов. Так же устроены и поисковые системы - круг замыкается на теме статьи.
Индексная страница - главный файл сайта или папки (index.html, index.php), который сервер отдаёт по умолчанию. К попаданию в поисковый индекс название файла отношения не имеет.
Выводы
Индексация сайта - это внесение страниц в базу поисковой системы: без неё страницы нет в поиске, какими бы хорошими ни были тексты. Проверить одну страницу можно за минуту операторами url: и site:, а точную картину дают Яндекс Вебмастер и Google Search Console. Ускоряют индексацию Sitemap, переобход, обход по счётчику Метрики, IndexNow для Яндекса и ссылки с проиндексированных страниц. Исключённые страницы - не всегда проблема: важно только, чтобы среди них не было нужных.
Главное:
- Индекс - база, по которой строится выдача; попасть в неё - условие показа, но не гарантия позиций.
- Срок в справке Яндекса - до двух недель после обхода, без гарантий; «Заявка обработана» не значит «в поиске».
- IndexNow и обход по Метрике работают только для Яндекса, для Google - Sitemap и проверка URL.
- robots.txt не убирает страницу из выдачи; для этого нужен noindex, пароль или удаление страницы.
Что делать дальше:
- Владельцу бизнеса - проверить главную страницу и две-три ключевые страницы оператором
url:и убедиться, что права в Вебмастере и Search Console подтверждены на аккаунт компании. - Маркетологу - открыть «Страницы в поиске» → «Исключенные страницы», отфильтровать причины с меткой «Чинить» из таблицы выше и составить список страниц для исправления и переобхода.
Если важные страницы выпадают из поиска, а причину не видно в панелях, разобраться поможет технический аудит сайта.
Как готовился материал
Автор - Александр Колодяжный, руководитель Webgard, старший SEO-специалист. Материал подготовила команда Webgard - SEO-студии с 14-летним опытом в поисковом продвижении.
Сроки, названия разделов и статусы сверены по справке Яндекс Вебмастера и документации Google Поиска 06.10.2026. Правила в примере robots.txt взяты с сайта webgard.ru в той же редакции. Числа в примере чтения отчёта условные. Ссылки на первоисточники стоят в тексте рядом с фактами, которые они подтверждают.